Q
从实验室“毕业”的 AI,进入真实世界之后,
怎么样了?
答案有点扎心:可能它就停在了“毕业”那一天。
大模型能写代码、能做研究、能回答各种问题 —— 但它的能力,在预训练结束那一刻就基本定型了。它能调取历史对话、能检索知识库,甚至能把失败写进“反思笔记”,但这些经验并没有从根本上重塑模型构建能力的机制。
换句话说,AI 能“翻旧账”,却未必真正“长本事”。
记住,却不等于学习。
当静态数据见顶,智能的新经验从哪来?面对没有现成答案的问题,模型能不能主动获得经验,并从中继续成长?
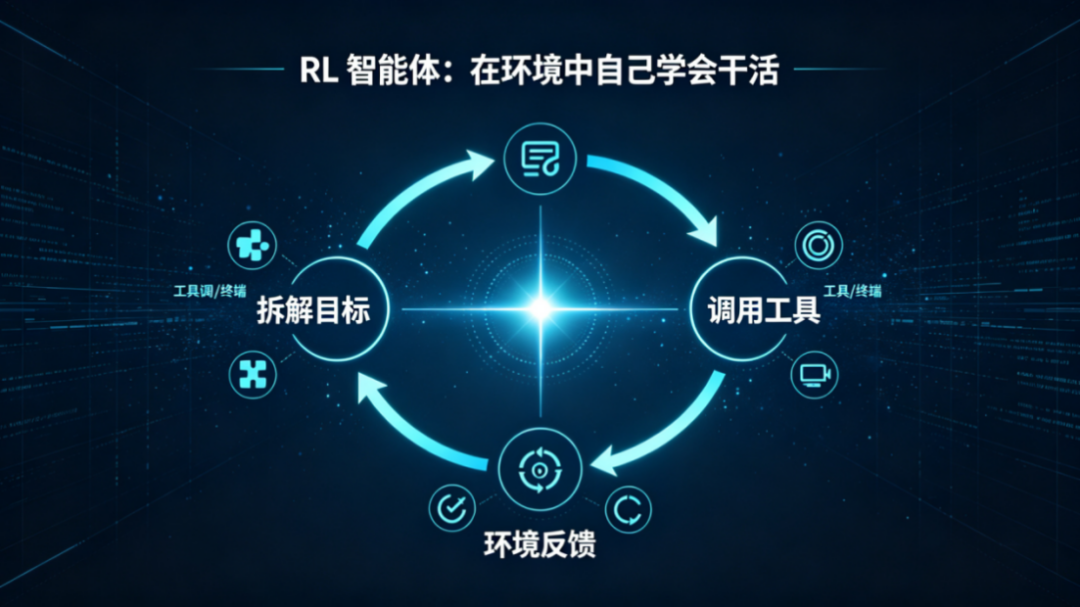
这正是赛砥英科选择进入的领域,也是这家刚刚入驻模速空间的新势力企业,试图用全栈 RL(强化学习)回答的问题——不是先训练出智能,再让智能去行动,让智能本身成为行动、预测、学习和规划不断循环产生的结果。
01
ONE
他们是谁?
赛砥英科的核心团队,源自阿尔伯塔大学 RLAI 实验室。该实验室由强化学习奠基人、图灵奖得主 Richard Sutton 创立,汇聚了前 DeepMind PI、AAAI Fellow 等学者,是全球 RL 理论的重要发源地 —— 诸多经典成果,奠定了现代 AI 决策范式的底层根基。
产业侧的力量同样扎实。核心团队中不乏多位拥有丰富RL产业经验的成员,有华为北美 AI Lab 的创立者、华为世界模型 RL 路线的早期核心奠基人,有主导过千万级用户游戏 AI 系统的技术负责人,也有主持国家重点专项的资深专家。从 AI 模型到自动驾驶、游戏终端设备,这支团队有一手的落地经验。
雄厚的学术和业界资源也是赛砥英科人才核心竞争力来源,团队依托清华大学及清华系企业生态:学术上有国家级高层次人才领衔,产业上有清华系企业的场景与渠道支持,资本上有头部 AI 生态基金加持 —— 从前沿科研、算力资源到产业落地,链路完整。这些资源构成了他们从实验室走向市场的真实底气。
02
TWO
智能上限的突破靠什么?
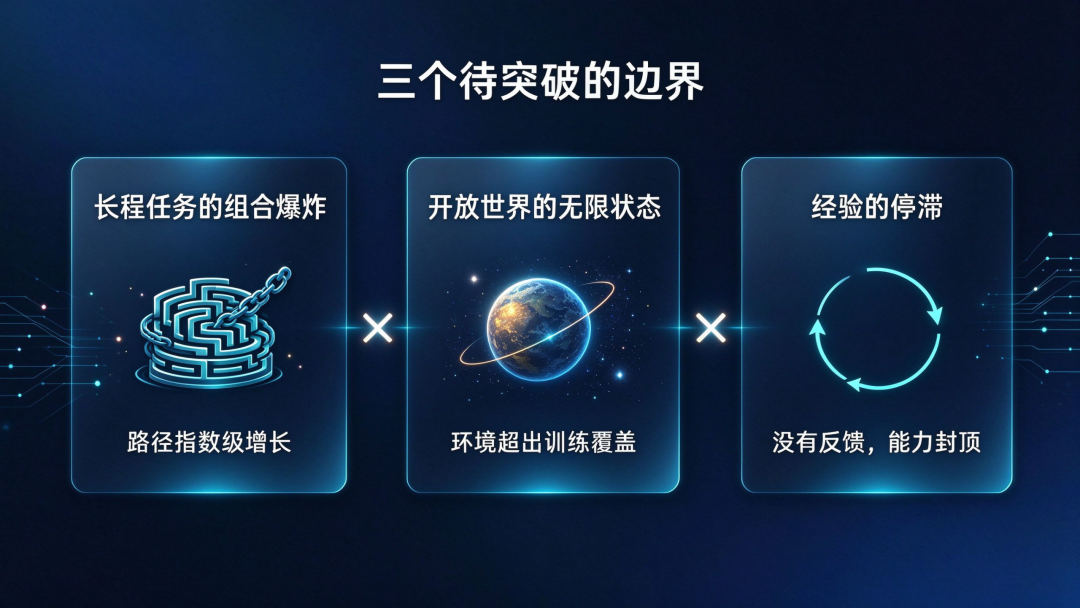
在赛砥英科看来,想让AI真正“长本事”,背后有三个仍待突破的边界。
第一,长程任务的组合爆炸
面对复杂长程任务,关键不仅是知道多少知识,更在于能否调动、关联和组合这些知识,构建跨越多个步骤的逻辑链,并保持推理与规划的一致性。任务越长,依赖越复杂,错误也越容易累积。
第二,开放世界的无限状态
真实环境中的问题、条件和约束不断变化,有限的训练数据难以覆盖所有可能。面对未知情境,智能不仅需要调用已有知识,还需要探索新的解决路径,并判断哪些尝试真正有效。
第三,经验的停滞
模型在复杂任务中,可以通过多次尝试、观察结果和利用反馈,不断修正推理,产生新的经验。但这些经验即使帮助它完成了当前任务,也未必会成为未来可复用的能力。经验的产生,不等于持久的学习。
这三个边界,共同勾勒出当前技术路线仍待突破的能力边界。
数据侧的信号,也在印证这个判断。Ilya Sutskever 在 NeurIPS 2024 的演讲中指出:“Pre-training as we know it will unquestionably end.”(我们所熟悉的预训练范式终将结束)。他把互联网中的训练数据比作 AI 的“化石燃料”:算力仍在增长,但可直接利用的高质量人类数据不能无限扩张。
问题不是预训练失去了价值,而是当静态数据的增长受限,智能需要新的学习来源。
03
THREE
一条路线:全栈 RL
数据见顶,智能的新来源在哪里?赛砥英科给出的答案,是 RL(强化学习)。
先澄清一个常见的误解:赛砥英科所说的 RL,并不只是训练末尾用来“对齐”行为的 RLHF(人类反馈强化学习,让模型更听话、更安全),而是让智能体在环境中行动、从反馈中学习,真正提升能力本身 —— 推理的深度,与复杂问题的求解能力。
这个方向有其理论脉络。2025 年,Richard Sutton 与David Silver 在《Welcome to the Era of Experience》中共同提出“体验时代”:未来 AI 的能力增长,将不再仅仅依赖人类积累的数据,而是越来越多地来自智能体与环境交互过程中产生的经验。Sutton 在 2026 年 WAIC 的演讲中,也再次强调了这一方向。
不是先训练出智能,再让智能去行动;而是智能本身,就是行动、预测、学习和规划不断循环产生的结果。
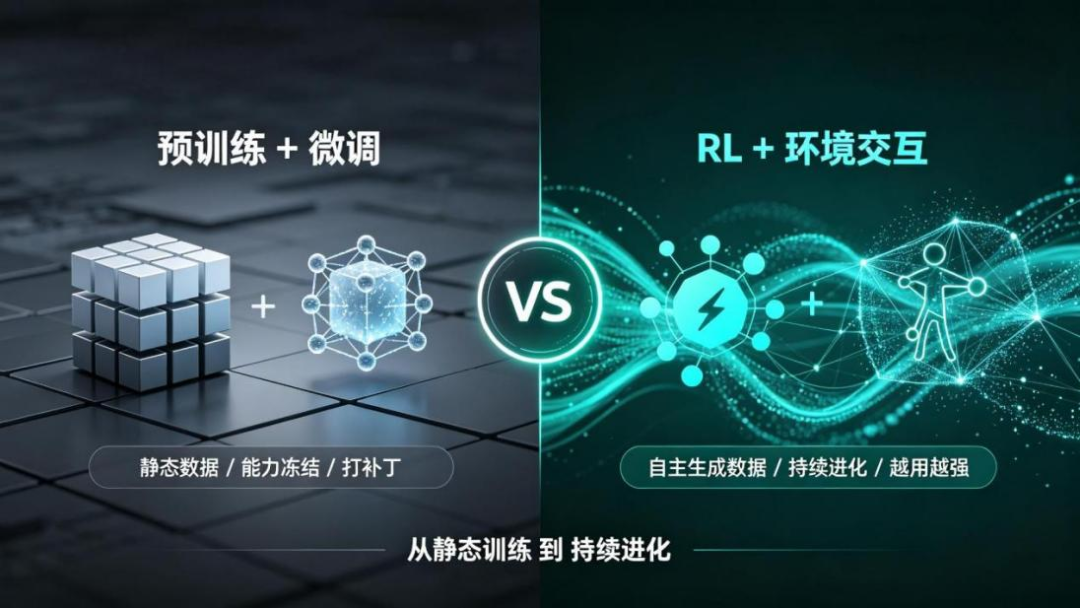
这背后,其实是一场“智能从哪来”的路线之争:
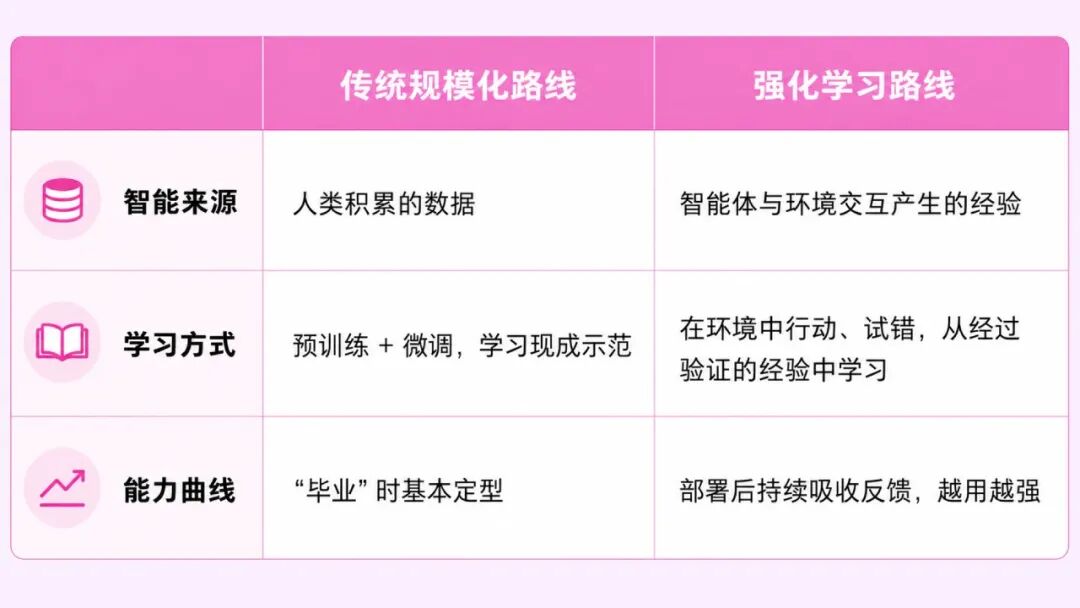
在赛砥英科看来,两者并非相互排斥 —— 但后者强调的持续学习,是进一步拓展当前能力边界的重要方向。
要让这种机制真正转化为稳定的能力提升,他们拆出了三层关键能力:
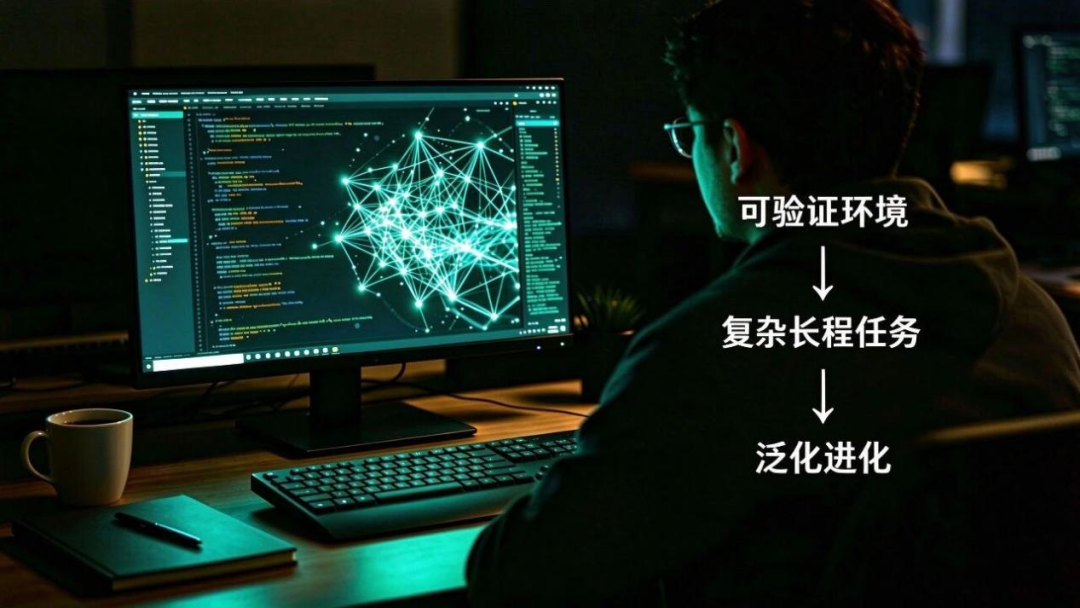
第一层:在可验证环境中学习。
选择从规则清晰、反馈明确的可验证环境入手 —— 让智能体在这样的环境里,通过与环境的持续交互,掌握自主学习的能力。
第二层:处理复杂长程任务。
当智能体学会了学习的方法,它就能高效处理那些今天最难自动化的复杂长程任务 —— 需要深度推理、需要多步规划、需要从失败中调整方向的任务。
第三层:泛化到更多真实场景。
我们真正相信的方向是:这套持续进化的能力,未来可以泛化到更多真实环境中,而不局限于某一个特定场景。
目前 AI 前沿正在涌现一批 RL 原生的 AI 实验室,但缺乏以 RL 为底层范式做自进化模型的新一代 AI 实验室。—— 这就是赛砥英科赋予自身的使命。
围绕这三层能力,赛砥英科的做法是“全栈”:将可验证环境、训练算法、模型架构、训练系统与推理部署协同设计,让经验的产生、验证与学习形成完整闭环,并持续研究更适合长程推理与持续学习的下一代网络架构。
在全栈之上,还有两个更进一步的探索:
递归自我改进(RSI)。让系统不仅训练更强的模型,还尝试自主发现能力短板、生成更有价值的训练任务、改进探索与验证方法,并通过评测筛选真正有效的改进 —— 不只是让模型学得更多,还要让学习的方法越来越有效。
专家能力融合(Ensemble RL)。不同领域的专家各有所长,让这些能力相互补充、迁移和协同,而不是简单叠加或彼此干扰 —— 让模型既保持专业深度,也逐步形成解决复杂问题的综合能力。
04
FOUR
落在哪里?
目前,这项技术正在游戏、机器人、自动驾驶、科学发现等高价值场景落地探索。
按赛砥英科的说法:这些场景只是起点,不是边界 —— 从可验证环境出发,一步步走向更复杂的真实世界。“模型决定一台 AI 从实验室‘毕业’时能做什么,而经验,决定它后来会成为什么。”这是赛砥英科写在公开分享里的一句话,也是他们选择这条路的理由。
智能的上界,是用来突破的。随着赛砥英科入驻模速空间,我们期待在这里,见证 RL 这条通往持续学习的路,走出更多真实进展。
如您想要了解赛砥英科的更多资讯,请点击阅读原文~